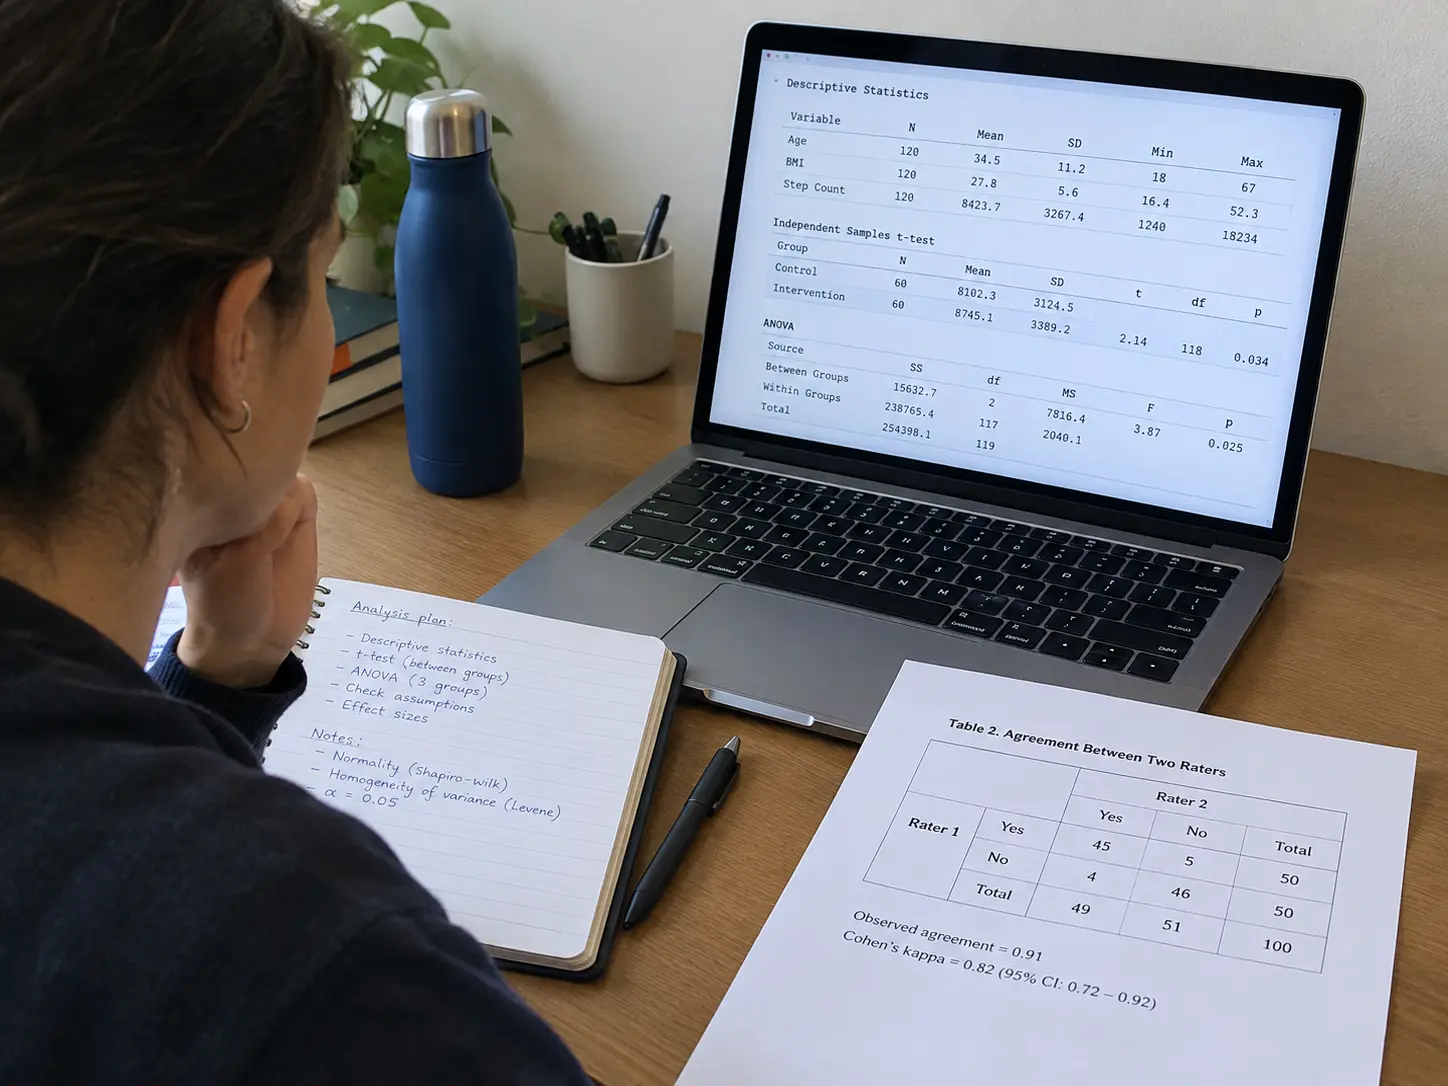
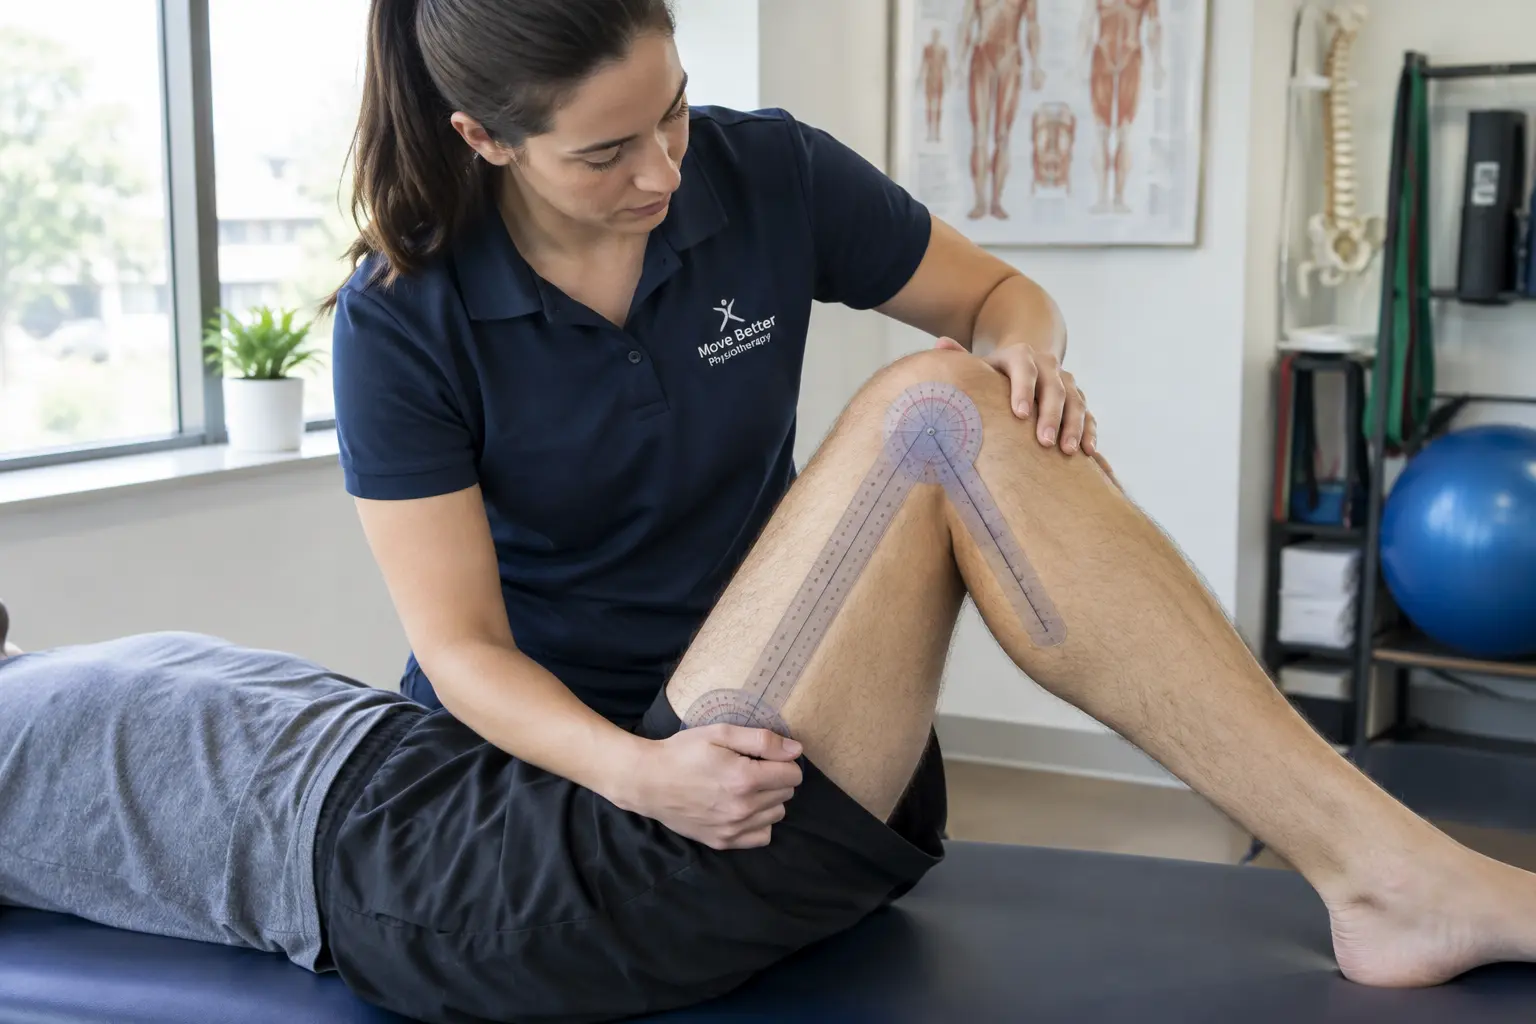
En un trabajo de grado de Fisioterapia es muy común que el «instrumento» no sea un cuestionario, sino una persona: un evaluador que mide el rango de movimiento con un goniómetro, observa una prueba de marcha, palpa o califica un movimiento. Y en ese caso la pregunta del jurado no es «¿cuál es su alfa de Cronbach?», sino «¿cuánto coinciden dos evaluadores que miden lo mismo?» o «¿cuánto coincide usted consigo mismo en dos días distintos?». Esa pregunta se responde con la confiabilidad interobservador e intraobservador, y con dos herramientas estadísticas que debes saber elegir: el coeficiente de correlación intraclase (ICC) para mediciones numéricas y el kappa de Cohen para categorías. Esta guía te explica cuándo usar cada uno, cómo se diseña un estudio de confiabilidad, cómo se interpreta y cómo se reporta en el capítulo metodológico, con un ejemplo de kappa calculado paso a paso.
Qué mide cada tipo de confiabilidad
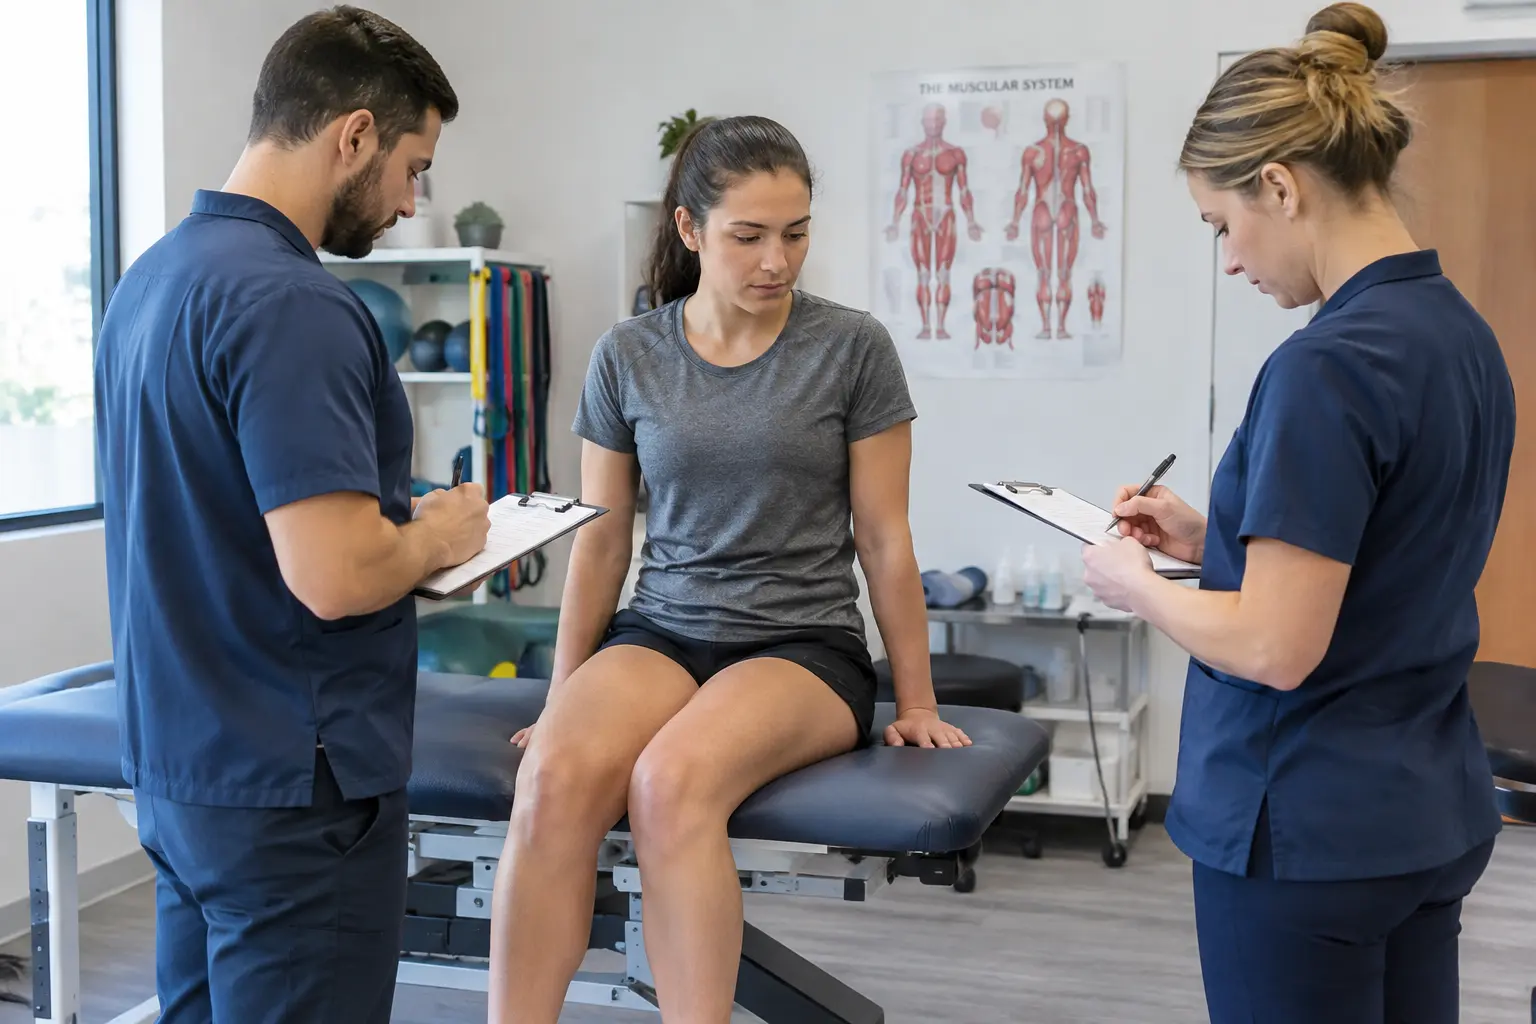
- Interobservador (interevaluador). Dos o más evaluadores miden a los mismos participantes y se compara su concordancia.
- Intraobservador (intraevaluador). El mismo evaluador mide a los mismos participantes en momentos distintos y se compara con sus propias mediciones.
- Test-retest. El mismo instrumento se aplica en dos momentos para ver si el resultado es estable.
- Consistencia interna. Se refiere a los ítems de un cuestionario; no aplica a una medición hecha con un goniómetro o a una observación clínica.
El artículo de Koo y Li (2016), «A Guideline of Selecting and Reporting Intraclass Correlation Coefficients for Reliability Research», publicado en el Journal of Chiropractic Medicine (volumen 15, número 2, páginas 155-163), explica que el ICC es un índice de confiabilidad muy usado en análisis test-retest, intraevaluador e interevaluador. Es la fuente que conviene citar para elegir y reportar correctamente un ICC.
Cuál herramienta usar según el tipo de dato
| Tipo de medición | Ejemplo en fisioterapia | Herramienta habitual |
|---|---|---|
| Numérica continua | Rango de movimiento en grados con goniómetro; circunferencia de un muslo en centímetros; tiempo de una prueba | ICC |
| Categórica (dos o más categorías) | Presencia o ausencia de un signo; clasificación de un patrón de marcha en categorías | Kappa de Cohen (dos evaluadores) |
| Ordinal | Grado de una escala de espasticidad o de fuerza | Kappa ponderado, o ICC según el caso; justifica tu elección |
La elección depende del tipo de dato que produce tu instrumento. Si dudas, consúltalo con tu director o con un estadístico antes de recolectar, porque una vez recogidos los datos no se puede cambiar la forma en que se midieron. Ubica tu instrumento en esa tabla antes de escribir el protocolo.
El ICC: diez formas, y debes decir cuál usaste
El mensaje central de Koo y Li es que existen diez formas del ICC, cada una con supuestos distintos y con interpretaciones diferentes; por eso, el investigador debe especificar explícitamente cuál usó. La mejor práctica de reporte incluye el software utilizado y las selecciones de «modelo», «tipo» y «definición». En términos prácticos, tu decisión se organiza en tres pasos:
- Modelo. Un modelo de efectos aleatorios de una vía, uno de dos vías de efectos aleatorios o uno de dos vías de efectos mixtos. La elección depende de si los evaluadores son una muestra de evaluadores posibles (y quieres generalizar) o son los únicos evaluadores de interés.
- Tipo. Si en la práctica se usará la medición de un solo evaluador o el promedio de varios.
- Definición. Consistencia o acuerdo absoluto. El acuerdo absoluto pregunta si evaluadores distintos asignan el mismo valor al mismo participante; la consistencia, si sus valores están correlacionados de manera aditiva. Los autores señalan que la definición de acuerdo absoluto produce, en general, un ICC menor que la de consistencia.
Un error habitual es calcular «el ICC» con la opción por defecto del programa sin saber cuál es. Anota en tu protocolo, antes de medir, qué modelo, tipo y definición usarás y por qué; y reporta el intervalo de confianza del 95 %, no solo el valor puntual.
Cómo interpretar el ICC
Koo y Li proponen interpretar el ICC con base en el intervalo de confianza del 95 %: valores inferiores a 0,5 indican confiabilidad pobre; entre 0,5 y 0,75, moderada; entre 0,75 y 0,9, buena; y superiores a 0,90, excelente. Lo importante es la palabra «intervalo»: si el estimado puntual es 0,82 pero el intervalo va de 0,55 a 0,93, tu conclusión no puede ser «buena confiabilidad», porque el límite inferior llega a un nivel moderado. Reporta y discute el intervalo completo.
Diseño del estudio de confiabilidad: cuántos participantes y cuántos evaluadores
Como regla práctica, Koo y Li sugieren intentar obtener al menos 30 muestras heterogéneas y contar con al menos tres evaluadores siempre que sea posible. «Heterogéneas» significa que los participantes deben variar en el rasgo que medirás: si todos tienen el mismo rango de movimiento, el ICC saldrá bajo aunque los evaluadores coincidan, porque no hay variabilidad que distinguir. En un trabajo de grado, conseguir tres evaluadores y treinta participantes puede ser difícil; si tu diseño tiene menos, decláralo como limitación y no lo presentes como si fuera la regla. La guía de cuántos participantes necesitas aborda el cálculo de tamaño en otros diseños.
Además del número, cuida estas condiciones del procedimiento: que los evaluadores trabajen de forma independiente y sin conocer las mediciones de los otros; que usen el mismo protocolo escrito y el mismo instrumento calibrado; que el orden de las mediciones esté balanceado o aleatorizado; y que el intervalo entre mediciones sea suficiente para evitar el recuerdo, pero lo bastante corto para que el rasgo no cambie.
El kappa de Cohen: ejemplo calculado paso a paso (datos ilustrativos)
El kappa se propuso en 1960 en el artículo de Jacob Cohen, «A coefficient of agreement for nominal scales», de la revista Educational and Psychological Measurement (volumen 20, número 1, páginas 37-46). Mide la concordancia entre dos evaluadores que clasifican en categorías, descontando la que se esperaría por azar. Un ejemplo con datos inventados: dos fisioterapeutas clasifican a 40 pacientes como «con signo positivo» o «sin signo». Ambos dicen positivo en 20 pacientes; el evaluador 1 dice positivo y el 2 negativo en 5; el evaluador 1 dice negativo y el 2 positivo en 3; ambos dicen negativo en 12.
- Concordancia observada. (20 + 12) / 40 = 0,80.
- Proporción de positivos de cada evaluador. El evaluador 1 dijo positivo en 25 de 40 pacientes (0,625); el evaluador 2, en 23 de 40 (0,575).
- Concordancia esperada por azar. 0,625 × 0,575 + 0,375 × 0,425 = 0,35938 + 0,15938 = 0,51875.
- Kappa. (0,80 − 0,51875) / (1 − 0,51875) = 0,28125 / 0,48125 = 0,584.
Fíjate en la lección: aunque los evaluadores coinciden en el 80 % de los casos, el kappa es 0,58, porque buena parte de esa coincidencia se esperaría por azar. Por eso no basta con reportar el porcentaje de acuerdo. Para interpretar el valor, existe el artículo de Landis y Koch (1977), «The measurement of observer agreement for categorical data», publicado en Biometrics (volumen 33, número 1, página 159), que propone categorías descriptivas para la magnitud del kappa; si las usas, cita ese artículo y recuerda que son convenciones y no reglas, y que el kappa depende de la prevalencia del signo y del número de categorías.
Cómo reportarlo en el capítulo metodológico
Una redacción completa incluye: el instrumento o la prueba evaluada y su protocolo; el número, la formación y la experiencia de los evaluadores; cuántos participantes se midieron y con qué criterios de inclusión; cómo se garantizó la independencia entre evaluadores y el orden de las mediciones; el intervalo entre mediciones; el software y la versión; para el ICC, el modelo, el tipo y la definición elegidos con su justificación; el valor del coeficiente con su intervalo de confianza del 95 %; y para el kappa, la tabla de contingencia, el valor y su interpretación citada. Un párrafo ilustrativo: «La confiabilidad interevaluador se estimó con un ICC de dos vías de efectos aleatorios, definición de acuerdo absoluto, medición de un solo evaluador, con intervalo de confianza del 95 %, calculado con el programa estadístico indicado en la sección de análisis». Si el trabajo involucra personas, recuerda tramitar el aval del comité según la guía de aval del comité de ética y Resolución 8430.
Cuándo otras evidencias de validez y confiabilidad también son necesarias
La confiabilidad entre evaluadores no demuestra que la prueba mida lo que dice medir. Para eso necesitas validez: de contenido, de criterio o de constructo, según la prueba. Si adaptas o construyes una lista de verificación para tu evaluación, consulta la guía de validez de contenido por juicio de expertos; si tu instrumento incluye un cuestionario con escala, la de alfa de Cronbach bajo. Dos instrumentos con el mismo nombre pueden comportarse distinto en poblaciones distintas, así que reporta los valores en tu muestra y no solo los de la publicación original.
Cómo buscar estudios previos de confiabilidad de tu prueba
Antes de diseñar tu propio estudio, comprueba qué se sabe de la prueba que vas a usar. Busca el nombre de la prueba junto con términos como «confiabilidad», «reliability», «interrater», «intrarater» y «reproducibilidad» en bases como PubMed, SciELO y Redalyc, y revisa si el estudio se hizo en población parecida a la tuya (edad, diagnóstico, nivel de actividad). Esos antecedentes te dan un valor de referencia para comparar tu ICC o tu kappa, y te permiten justificar el tamaño de tu muestra. La guía de revistas y bases de datos para un trabajo de grado de fisioterapia deportiva reúne fuentes para esa búsqueda. Si tu medición se hace con un instrumento físico, como un goniómetro, un dinamómetro o un cronómetro, registra además su marca, modelo y calibración, porque la confiabilidad del evaluador no incluye el error del aparato.
Un protocolo de una página que le puedes llevar a tu director
Antes de empezar a medir, redacta un protocolo corto con estos apartados: objetivo del estudio de confiabilidad; participantes y criterios de inclusión y exclusión; evaluadores, su formación y su entrenamiento previo; instrumento y calibración; descripción paso a paso de la medición; orden de las mediciones y tiempo entre ellas; formato de registro independiente por evaluador; coeficiente elegido, con modelo, tipo y definición si es ICC; y plan para datos faltantes. Un protocolo así se revisa en una reunión y evita el error más costoso de estos estudios: descubrir, con los datos ya recogidos, que los evaluadores no registraron de forma independiente o que la muestra no variaba lo suficiente. También te sirve de base para la sección de métodos y como anexo ante el comité de ética.
Errores frecuentes
- Calcular el ICC sin especificar modelo, tipo y definición.
- Reportar solo el valor puntual del ICC sin su intervalo de confianza.
- Usar una muestra homogénea de participantes y concluir que la confiabilidad es baja.
- Reportar solo el porcentaje de acuerdo para variables categóricas, sin corregir por azar.
- Permitir que los evaluadores vean las mediciones de los otros.
- Usar el coeficiente de correlación de Pearson como si fuera una medida de acuerdo entre evaluadores.
- No declarar como limitación un número pequeño de evaluadores o de participantes.
Preguntas frecuentes
¿Cuál es la diferencia entre confiabilidad interobservador e intraobservador?
La interobservador compara a evaluadores distintos que miden a los mismos participantes; la intraobservador compara al mismo evaluador en momentos distintos.
¿Cuándo uso ICC y cuándo kappa?
El ICC es la herramienta habitual para mediciones numéricas, como grados de movimiento; el kappa de Cohen, para clasificaciones en categorías hechas por dos evaluadores. Para escalas ordinales conviene justificar la elección con tu director.
¿Qué valor de ICC se considera bueno?
Koo y Li proponen interpretarlo con el intervalo de confianza del 95 %: menos de 0,5, pobre; entre 0,5 y 0,75, moderado; entre 0,75 y 0,9, bueno; y más de 0,90, excelente.
¿Cuántos evaluadores y participantes necesito?
Como regla práctica, los mismos autores sugieren al menos 30 muestras heterogéneas y al menos 3 evaluadores siempre que sea posible. Si tu diseño tiene menos, decláralo como limitación.
¿Puedo usar el alfa de Cronbach para la confiabilidad de una medición clínica?
El alfa se refiere a la consistencia interna de los ítems de un cuestionario; para mediciones hechas por evaluadores, lo adecuado es la confiabilidad interevaluador o intraevaluador con ICC o kappa.
Cómo seguir
Define ahora el tipo de dato de tu medición y escríbelo en una línea: «numérica, evaluada por dos fisioterapeutas». De ahí se derivan el coeficiente, el número de participantes y la sección de análisis. Con esa línea, llévale a tu director un protocolo de una página que indique evaluadores, participantes, orden de mediciones, intervalo y coeficiente: es el documento que evita rehacer la recolección.