Terminaste de digitar las 112 encuestas, corriste la primera prueba y el promedio de edad te dio 47 años en una muestra de estudiantes de pregrado. No es un hallazgo: es un 4 que se convirtió en 47 porque alguien pulsó una tecla de más.
Entre recoger los datos y analizarlos hay un paso que casi nadie enseña y que decide si tus resultados significan algo: la depuración de la base. Son unas dos horas de trabajo con una rutina fija, y evitan tanto el papelón como el rehacer todo el capítulo de resultados.
Antes de empezar: guarda el original y no lo toques más
Primera regla, y la que más gente se salta: nunca depures sobre el archivo original. Duplica el archivo, nómbralo con la fecha y el sufijo _depurada, y trabaja siempre sobre la copia. Si algo sale mal —y siempre sale algo— puedes volver.
Segunda: abre una hoja de bitácora de depuración desde el minuto uno. Cuatro columnas: qué encontraste, en qué caso o variable, qué hiciste y por qué. Esa hoja se convierte después en tres párrafos del capítulo de método y en un anexo. Reconstruirla al final es imposible.
Paso 1: rangos imposibles
Pide los valores mínimo y máximo de cada variable numérica y las frecuencias de cada variable categórica. En dos minutos aparecen casi todos los errores de digitación.
- Edad de 4 o de 470 en una muestra de universitarios.
- Un 6 en una escala Likert de 1 a 5.
- Un 3 en una variable dicotómica codificada 1 = sí, 2 = no.
- Categorías que deberían ser 4 y aparecen 7, porque «Femenino», «femenino» y «F» se digitaron distinto.
Los errores de rango casi nunca son un problema de la persona que respondió: son de digitación. Vuelve al instrumento físico o al formulario en línea, mira qué dice y corrige. Corregir contra la fuente es la única corrección legítima. Si no puedes verificarla —el formulario se perdió, la respuesta es ilegible— el valor se marca como perdido, no se «arregla» a ojo.
Un caso especial: el cero que en realidad es un vacío
Si dejaste la celda en 0 cuando la persona no respondió, ese cero entra en los cálculos como si fuera una respuesta. Un promedio de satisfacción de 3,2 se convierte en 2,4 por catorce ceros que en realidad eran silencios. Los no respondidos se codifican con un valor imposible reservado —99, 999— y se declaran como perdidos en el programa, o simplemente se dejan vacíos. Nunca cero.
Paso 2: duplicados
Dos causas frecuentes: la misma persona envió el formulario dos veces, o la misma encuesta se digitó dos veces. Se detectan buscando registros idénticos en un conjunto de variables que difícilmente coincidirían por azar: fecha y hora de envío, más tres o cuatro respuestas.
Ojo con el falso positivo: dos personas del mismo programa, mismo semestre y mismo sexo pueden coincidir legítimamente en las variables demográficas. La coincidencia tiene que ser en el patrón completo de respuestas.
Paso 3: valores perdidos
Lo primero no es decidir qué hacer, sino mirar el patrón. Cuenta cuántos perdidos hay por variable y cuántos por caso, y observa dónde se concentran.
| Patrón | Qué suele significar | Qué hacer |
|---|---|---|
| Pocos, dispersos por toda la base | Descuido al responder | Poco problemático; documenta el porcentaje |
| Concentrados en una variable | La pregunta es sensible, confusa o mal ubicada | Analiza esa variable aparte y explica la pérdida |
| Concentrados en un caso (deja media encuesta sin responder) | Abandono a mitad del formulario | Candidato a eliminar el caso completo |
| Concentrados al final del instrumento | Cansancio o falta de tiempo | Es un hallazgo sobre el instrumento; menciónalo |
La tercera fila es la que más importa: que una variable pierda respuestas no es igual a que una persona abandone. Un caso con el 60 % de las preguntas sin responder aporta poco y distorsiona; eliminarlo es defendible si el criterio se fija de antemano y se declara.
Las tres salidas, en orden de preferencia
- Analizar solo los casos completos para cada análisis. Es lo que hacen los programas por defecto. Es transparente, pero tiene un efecto que hay que vigilar: si cada análisis usa un número distinto de casos, hay que reportar la n de cada uno. Nunca escribas «n = 112» en el encabezado si la prueba se corrió con 94.
- Eliminar los casos con pérdida masiva según un criterio fijado antes (por ejemplo, más del 20 % de los ítems sin responder), y reportar cuántos se eliminaron.
- Imputar. Sustituir el valor perdido por una estimación. Para una escala con pocos ítems faltantes se usa a veces la media de los demás ítems de esa dimensión para esa misma persona. Es aceptable si son pocos casos, se declara, y no se aplica a la variable de resultado principal. Imputar la mitad de una base no es depurar: es inventar datos.
Regla de oro: cualquiera de las tres es válida si está escrita en el método. La que nunca es válida es probar varias y quedarse con la que da significativo.
Paso 4: valores atípicos
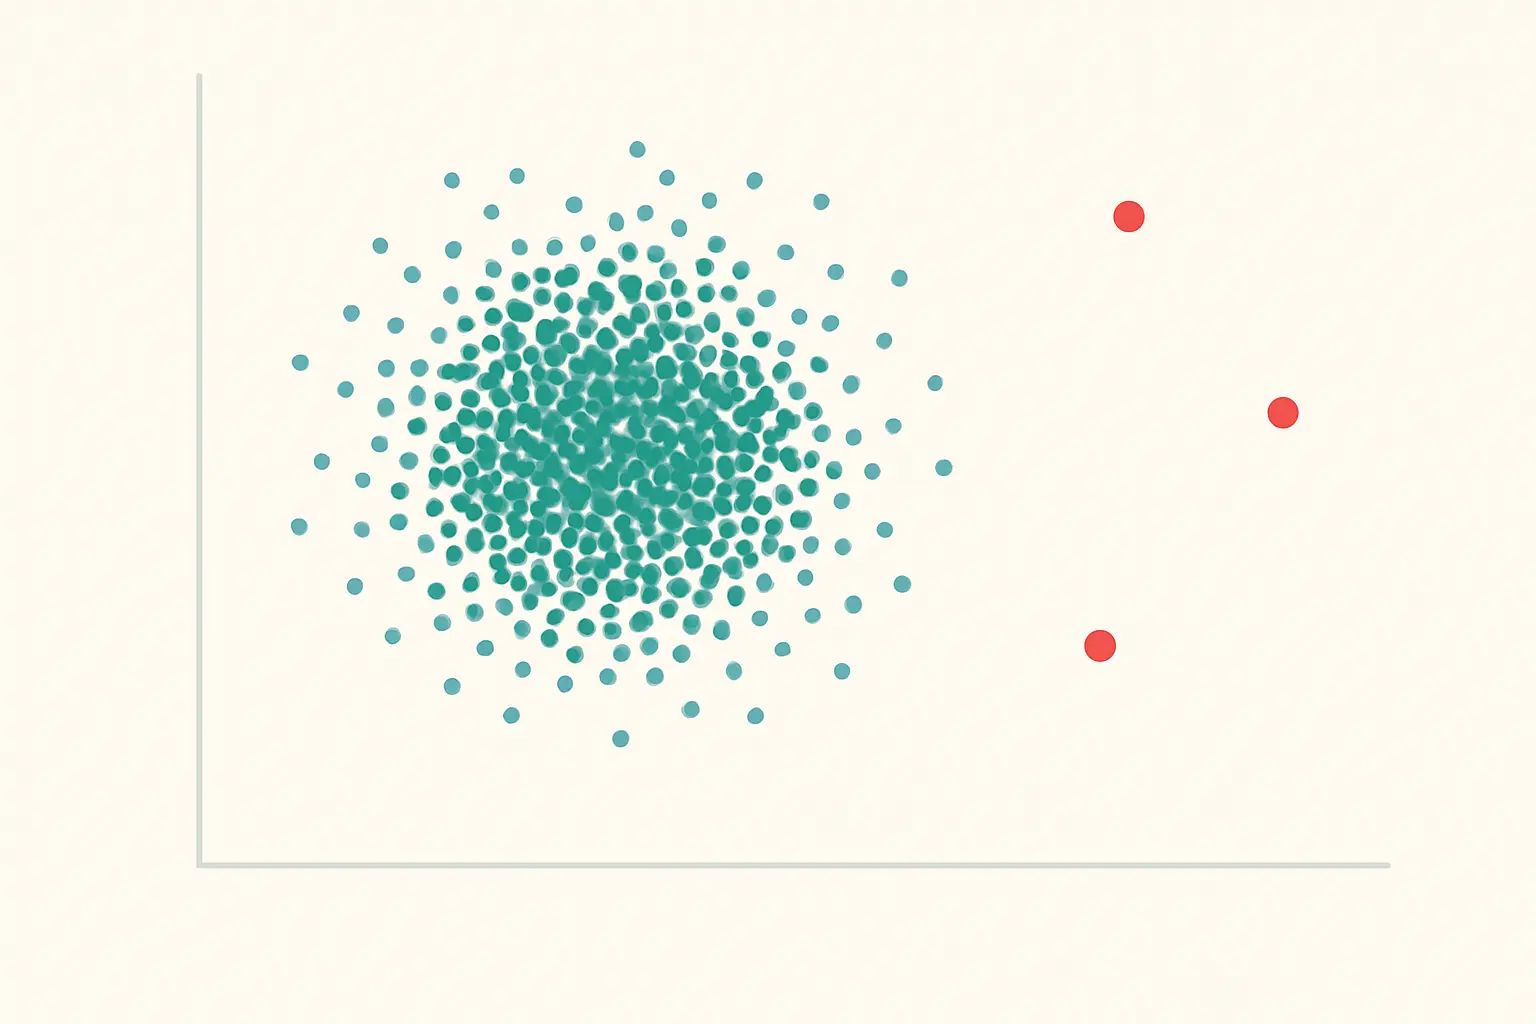
Un valor atípico es un dato muy alejado del resto. Detectarlo es fácil; decidir qué hacer con él es donde se juega la honestidad del trabajo.
Cómo detectarlos
- Diagrama de caja. El método visual estándar: marca como atípicos los valores que caen más allá de vez y media el rango intercuartílico desde los cuartiles.
- Puntuaciones estandarizadas. Convertir la variable a puntajes tipificados y revisar los que superan 3 en valor absoluto.
- Diagrama de dispersión cuando el atípico solo lo es en la combinación de dos variables: una persona de 19 años con 22 años de experiencia laboral no es rara en ninguna de las dos por separado.
La pregunta que decide
No es «¿qué tan lejos está?», sino «¿es un error o es un caso real?».
- Es un error si contradice la fuente (el formulario dice 4 y la base dice 47) o si es físicamente imposible. Se corrige o se marca como perdido.
- Es un caso real y extremo si la persona realmente respondió eso. Entonces se conserva. Un empleado con veinte años en la empresa dentro de una muestra de recién vinculados es información, no ruido.
Si un caso real y extremo te preocupa porque mueve mucho el resultado, la salida correcta no es borrarlo: es correr el análisis con y sin él y reportar ambos. «El resultado se mantiene al excluir los tres casos extremos (p = ,004 frente a p = ,007)» es una de las frases que más confianza genera en un capítulo de resultados. Eliminar sin decirlo, en cambio, es exactamente el terreno en el que se mueve la falsificación de datos, y sus señales están descritas en la guía sobre fabricación y falsificación de datos.
Paso 5: coherencia interna entre variables
Errores que ninguna revisión de rangos detecta porque cada valor, por separado, es plausible:
- Dice tener 20 años y 15 años de antigüedad laboral.
- Marcó «no aplica» en una pregunta filtro y luego respondió todas las preguntas dependientes.
- Sumó puntajes parciales que no cuadran con el total.
- Fecha de ingreso posterior a la fecha de retiro.
Se detectan con dos o tres reglas de validación cruzada escritas a mano. Elige las tres combinaciones donde una inconsistencia sería más grave para tu análisis y revísalas explícitamente.
Paso 6: recodificaciones que van antes del análisis
Tres transformaciones que deben quedar hechas y verificadas en la base depurada:
- Ítems invertidos. En una Likert de 1 a 5, el nuevo valor es 6 − valor original. Verifica el resultado en tres casos a mano. Un solo ítem invertido sin recodificar puede desplomar la fiabilidad; el diagnóstico completo está en la guía sobre qué hacer si el alfa de Cronbach sale bajo.
- Puntajes totales y por dimensión. Créalos como variables nuevas, nunca sobrescribiendo los ítems.
- Agrupaciones. Si vas a comparar por rangos de edad o de antigüedad, crea la variable de grupo ahora y con criterios justificados, no después de mirar dónde da significativa la diferencia.
Ese último punto tiene nombre y consecuencia: definir los puntos de corte después de ver los resultados infla el riesgo de falso positivo. Los grupos se definen en el diseño, en la misma línea que la columna de análisis de tu matriz de consistencia.
Cómo se escribe en el capítulo de método
Un párrafo, con cifras concretas:
«Se recibieron 118 respuestas. Se eliminaron 4 registros duplicados y 2 casos con más del 20 % de ítems sin responder, para una base final de 112 casos. Se identificaron 7 valores fuera de rango, corregidos contra el formulario original en 5 casos y codificados como perdidos en 2. Los valores perdidos restantes (1,8 % del total de celdas) se trataron mediante análisis de casos completos, por lo que la n se reporta en cada tabla. Se conservaron 3 valores atípicos verificados como respuestas reales; el análisis principal se repitió excluyéndolos, sin cambios en las conclusiones.»
Ese párrafo hace tres cosas a la vez: informa, muestra que el proceso fue sistemático y desactiva por adelantado las preguntas más probables del jurado.
Errores frecuentes
- Depurar sobre el archivo original. Sin copia de seguridad no hay vuelta atrás.
- Codificar los no respondidos como cero. El error que más distorsiona promedios.
- Eliminar atípicos porque «dañan» el resultado. Si son reales, se quedan; si te preocupan, reportas con y sin ellos.
- No documentar nada. Un capítulo de método que salta de «se aplicó el instrumento» a «se realizó el análisis» deja un hueco visible.
- Reportar una sola n para todos los análisis cuando cada prueba usó un subconjunto distinto.
- Depurar después de haber corrido los análisis. Entonces la limpieza deja de ser depuración y empieza a parecer selección.
Preguntas frecuentes
¿Qué hago con los valores perdidos de mi encuesta?
Primero mira el patrón: cuántos hay por variable y por caso. Si son pocos y dispersos, basta con analizar los casos completos y reportar la n de cada prueba. Si un caso dejó sin responder una parte grande del instrumento, elimínalo según un criterio fijado de antemano. La imputación es aceptable para pocos ítems faltantes dentro de una escala, siempre que se declare.
¿Puedo eliminar los valores atípicos?
Solo si son errores verificables contra la fuente original o valores imposibles. Si el dato extremo es una respuesta real, se conserva. Cuando un caso real influye mucho en el resultado, la práctica correcta es correr el análisis con y sin él y reportar ambos resultados, no eliminarlo en silencio.
¿Cómo detecto errores de digitación?
Pidiendo el mínimo y el máximo de cada variable numérica y la tabla de frecuencias de cada variable categórica. Los valores fuera del rango posible, las categorías que aparecen de más y los códigos inexistentes saltan de inmediato. Después, revisa dos o tres reglas de coherencia entre variables que no detecta ninguna revisión de rangos.
¿Es válido codificar los no respondidos con 99?
Sí, siempre que declares ese código como valor perdido en el programa antes de analizar. El punto crítico es no dejarlo como un número que entre en los cálculos: un 99 tratado como respuesta destroza cualquier promedio. La alternativa es dejar la celda vacía.
¿Hay que reportar la depuración en el trabajo de grado?
Sí, en el capítulo de método, con cifras: cuántos registros se recibieron, cuántos se eliminaron y por qué, qué porcentaje de datos faltaba y cómo se trató. Es información que el jurado espera y que además protege tu trabajo: muestra que las decisiones se tomaron con criterio y antes de ver los resultados.
¿Necesito un programa especial para depurar?
No. Una hoja de cálculo permite revisar rangos, buscar duplicados y detectar celdas vacías; los programas estadísticos añaden los diagramas de caja y los resúmenes de perdidos con un clic. La comparación entre alternativas gratuitas y de pago está en la guía de SPSS, R, jamovi y JASP.
Después de la limpieza
Con la base depurada y la bitácora escrita, ya puedes pasar al análisis con la tranquilidad de que lo que salga significa algo. El siguiente paso es elegir la prueba, y esa decisión se resuelve en cuatro preguntas en la guía de qué prueba estadística elegir. Cuando llegues a escribir los números, las convenciones de coma decimal, cursiva y redondeo evitan el otro error de formato clásico.
Escribe tu capítulo de resultados en Tesify y ve dejando registradas las decisiones de depuración mientras avanzas, con las referencias en su sitio. Más de 9.000 estudiantes ya escriben así, y el texto sigue siendo cien por ciento tuyo.