Corriste una correlación, se la mostraste a tu director y te respondió lo mismo que le responden a casi todo el mundo: «bien, pero eso no controla nada; córrele una regresión múltiple». Y ahí te quedaste, porque el manual de la clase explicaba la regresión simple con dos variables y tu modelo tiene cinco.
Esta guía te lleva por el camino completo con una sola pregunta de ejemplo: ¿el promedio acumulado de un estudiante se explica por las horas de estudio semanales, las horas de trabajo remunerado, el estrato y el hecho de vivir o no con la familia? Todo lo que sigue se aplica igual a tu tema.
Qué responde una regresión múltiple (y qué no)
Una regresión lineal múltiple estima cuánto cambia una variable dependiente cuantitativa cuando cambia un predictor, manteniendo constantes los demás. Esa última frase es todo el valor del método y la razón por la que tu director la pidió: sin ella, la relación entre horas de estudio y promedio puede ser en realidad el efecto del estrato colándose por detrás.
Lo que la regresión no hace es demostrar causalidad. Con datos observacionales de una encuesta transversal —el diseño más común en un trabajo de grado colombiano— puedes escribir «se asocia con» y «predice», nunca «causa». Si tu pregunta es causal, el problema no está en el análisis sino en el diseño, y conviene revisarlo antes de recoger nada.
Si todavía no tienes claro que la regresión sea la técnica que te corresponde, empieza por el mapa de decisión de qué prueba estadística elegir: la regresión aparece cuando quieres predecir una variable cuantitativa a partir de varias, no cuando quieres comparar dos grupos.
Cuántos predictores aguanta tu muestra
Esta es la primera pregunta que hace un jurado con formación cuantitativa, y la que más modelos tumba. Meter siete predictores con 60 casos produce coeficientes que parecen resultados y son ruido.
La regla de referencia más citada es la de Samuel Green, publicada en Multivariate Behavioral Research (1991, 26, 499-510, DOI 10.1207/s15327906mbr2603_7). Green propone dos mínimos distintos, según lo que quieras defender:
- Si te interesa el modelo completo (probar que el conjunto de predictores explica algo): N ≥ 50 + 8m, donde m es el número de predictores. Con cuatro predictores, 82 casos.
- Si te interesa cada predictor por separado (decir cuál pesa y cuál no): N ≥ 104 + m. Con cuatro predictores, 108 casos.
Son reglas de dedo pensadas para tamaños de efecto medianos, no leyes. Green mismo advierte que con efectos pequeños hacen falta muestras bastante mayores. Lo importante para tu documento es que declares cuál usaste y por qué: un jurado acepta sin problema «se siguió el criterio de Green (1991) para efectos medianos», y rechaza «se encuestó a los que respondieron».
Si tu variable dependiente es dicotómica —aprobó / no aprobó, desertó / no desertó— no estás en regresión lineal sino logística, y la regla cambia: se cuenta por eventos por variable, es decir por casos de la categoría menos frecuente. El estándar clásico son diez eventos por predictor (Peduzzi et al., Journal of Clinical Epidemiology, 1996, 49, 1373-1379, DOI 10.1016/S0895-4356(96)00236-3). Vittinghoff y McCulloch mostraron después que ese diez es conservador y que entre cinco y nueve suele bastar (American Journal of Epidemiology, 2007, 165, 710-718, DOI 10.1093/aje/kwk052). Cita la que uses.
Si aún estás definiendo el tamaño de la muestra y no solo comprobándolo, la cuenta completa está en la guía de cómo calcular el tamaño de la muestra.
Cómo entran las variables al modelo
Un predictor cuantitativo entra tal cual. Uno categórico, no: hay que convertirlo en variables indicadoras (dummy). La regla es que una variable con k categorías produce k − 1 dummies, y la categoría que dejas por fuera se convierte en la categoría de referencia contra la que se interpretan todas las demás.
En el ejemplo, «vive con la familia» es dicotómica y entra como una sola dummy (0 = no, 1 = sí). El estrato, si lo tratas como categórico de seis niveles, produce cinco dummies y todos los coeficientes se leen «frente al estrato 1». Si lo tratas como cuantitativo estás asumiendo que la distancia entre estrato 1 y 2 vale lo mismo que entre 5 y 6: es una decisión defendible, pero hay que declararla. Ese tipo de decisión es exactamente lo que se documenta en la operacionalización de variables, y conviene tenerla escrita antes de correr nada.
Si dudas de qué papel cumple cada variable en tu modelo —dependiente, independiente, control, interviniente— la clasificación completa está en tipos de variables de investigación.
Los cuatro supuestos que sí te van a preguntar
Los supuestos de la regresión no se revisan sobre las variables originales sino sobre los residuos, que son la diferencia entre lo que el modelo predice y lo que realmente observaste. Esta confusión es la más frecuente en los capítulos de resultados que se devuelven corregidos.
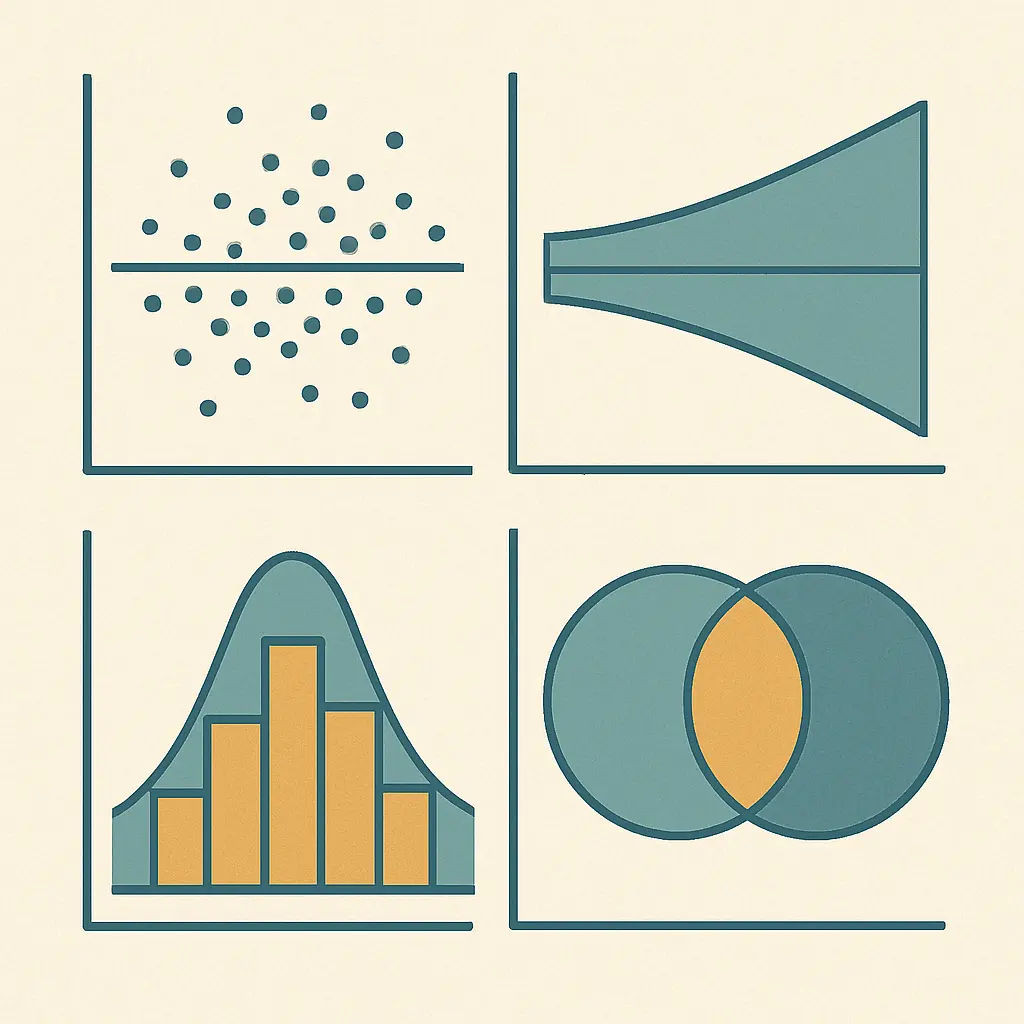
- Linealidad. La relación entre cada predictor y la dependiente debe ser aproximadamente recta. Se revisa con el gráfico de residuos frente a valores pronosticados: si ves una curva, el modelo lineal no es el adecuado.
- Independencia de los residuos. Cada observación debe aportar información nueva. Se resume con el estadístico de Durbin-Watson, que se interpreta alrededor de 2. Si encuestaste varias veces a la misma persona, o a estudiantes anidados dentro de cursos, este supuesto está roto por diseño y ningún estadístico lo arregla.
- Homocedasticidad. La dispersión de los residuos debe ser pareja a lo largo de todos los valores pronosticados. En el mismo gráfico anterior, una nube que se abre en forma de embudo es heterocedasticidad.
- Normalidad de los residuos. No de las variables: de los residuos. Se mira con el histograma de residuos estandarizados y el gráfico Q-Q. Con muestras grandes, una desviación moderada no invalida el modelo.
A esos cuatro se suma el chequeo de casos influyentes: uno o dos datos extremos pueden mover un coeficiente entero. La distancia de Cook es el indicador estándar y el criterio habitual es revisar a mano todo caso con valor superior a 1.
Multicolinealidad: qué es y qué dice de verdad el VIF
La multicolinealidad aparece cuando dos o más predictores miden en buena parte lo mismo. En el ejemplo es muy probable: horas de trabajo remunerado y estrato están correlacionados. El modelo en conjunto puede seguir prediciendo bien, pero los coeficientes individuales se vuelven inestables —cambian mucho si quitas un caso— y sus errores estándar se inflan, así que un predictor real puede salir «no significativo».
El indicador es el factor de inflación de la varianza (VIF). Se calcula un VIF por predictor y su lectura es directa: un VIF de 4 significa que la varianza de ese coeficiente es cuatro veces más grande de lo que sería si el predictor no estuviera correlacionado con los demás. La tolerancia es simplemente 1/VIF y dice lo mismo al revés.
Los umbrales que circulan —VIF > 10, o > 5— se citan como si fueran normas y no lo son. Robert O’Brien lo documentó en Quality & Quantity (2007, 41, 673-690, DOI 10.1007/s11135-006-9018-6): esas cifras carecen de fundamento estadístico general, porque el daño que hace la colinealidad depende también del tamaño de la muestra y de la varianza del predictor. Con una muestra grande, un VIF alto puede ser perfectamente tolerable; con 80 casos, un VIF de 6 ya es un problema real.
Qué hacer si te sale alto, en orden de preferencia:
- Revisa si son la misma cosa medida dos veces. Si incluiste «ingreso del hogar» y «estrato», elige uno y justifica cuál mide mejor tu constructo.
- Combínalos. Dos ítems que miden lo mismo pueden promediarse en un índice, si tiene sentido teórico.
- Céntralos restando la media, cuando la colinealidad viene de haber incluido un término de interacción o un cuadrado.
- Déjalos y declara la limitación. Es una opción legítima si el predictor es teóricamente indispensable; lo que no es legítimo es no reportar el VIF.
Cómo leer la salida sin equivocarte de número
Los cuatro números que importan, en el orden en que se leen:
- R² y R² ajustado. La proporción de varianza explicada. Reporta siempre el ajustado en regresión múltiple: el R² simple sube mecánicamente cada vez que agregas un predictor, aunque sea basura.
- El estadístico F de la ANOVA del modelo. Prueba si el conjunto de predictores explica algo más que el azar. Si sale no significativo, no tiene sentido interpretar coeficientes individuales.
- B (no estandarizado) frente a β (estandarizado). B está en las unidades reales —«por cada hora adicional de estudio, el promedio sube 0,08 puntos»— y es el que se interpreta sustantivamente. β está en desviaciones estándar y sirve para comparar la fuerza relativa de predictores medidos en escalas distintas.
- El intervalo de confianza de B. Pídelo siempre en las opciones del programa. Un intervalo que cruza el cero dice lo mismo que p > ,05, pero además te dice cuán grande podría ser el efecto real.
Los pasos concretos en la interfaz —dónde está el menú, qué casillas marcar— dependen del programa; la comparación entre SPSS, R, jamovi y JASP está en esta guía de programas, y la preparación previa de la base en análisis de datos cuantitativos con SPSS y Excel.
Cómo se escribe el resultado
En el texto va la síntesis del modelo y en la tabla van los coeficientes. Una redacción que funciona:
El modelo con los cuatro predictores resultó significativo, F(4, 103) = 9,42; p < ,001; R²ajustado = ,24. Las horas de estudio semanales predijeron positivamente el promedio acumulado (B = 0,08; IC 95 % [0,04; 0,12]; β = ,31; p < ,001), mientras que las horas de trabajo remunerado lo predijeron negativamente (B = −0,03; IC 95 % [−0,05; −0,01]; β = −,22; p = ,004). Todos los VIF estuvieron por debajo de 2,1.
Fíjate en tres detalles de forma que en Colombia se piden con frecuencia: el separador decimal es la coma, los estadísticos que no pueden superar 1 —como p, R² y β— van sin cero inicial, y las letras que representan estadísticos van en cursiva. El armado de la tabla, con sus notas y su numeración, está resuelto en cómo presentar los resultados con tablas y figuras. Verifica siempre en el reglamento de tu programa si te exigen Icontec NTC 1486 o APA 7, porque eso cambia el formato de la tabla, no el contenido.
Los cinco errores que más devuelven un capítulo
- Interpretar un modelo con F no significativo. Si el conjunto no explica nada, los coeficientes individuales no se comentan.
- Reportar R² en vez de R² ajustado. Delata que no se entendió por qué hay dos.
- No reportar el VIF. Es una línea en la tabla y evita la pregunta más previsible del jurado.
- Usar lenguaje causal. «Influye», «genera» y «determina» no se sostienen en un diseño transversal; «se asocia» y «predice», sí.
- Meter predictores hasta que algo salga significativo. El modelo se define antes de correrlo, a partir del marco teórico, y se reporta completo aunque los resultados no acompañen.
Preguntas frecuentes
¿Cuántos predictores puedo meter si tengo 90 encuestas?
Con el criterio de Green para el modelo completo (N ≥ 50 + 8m), 90 casos admiten cinco predictores. Si además quieres interpretar cada coeficiente por separado, el criterio más exigente (N ≥ 104 + m) no se cumple con 90, así que conviene reducir el modelo o declarar la limitación.
¿Qué VIF es «demasiado alto»?
No hay un umbral universal. Los valores de 5 y 10 son convenciones sin base estadística general, según O’Brien (2007); el efecto real depende del tamaño de la muestra y de la varianza del predictor. Reporta el VIF de cada predictor y discute el caso concreto en lugar de aplicar un corte.
¿Los supuestos se revisan sobre las variables o sobre los residuos?
Sobre los residuos. La normalidad que importa es la de los residuos del modelo, no la de la variable dependiente ni la de los predictores; ese es el error más frecuente en los capítulos de resultados.
¿Puedo usar una variable categórica como predictor?
Sí, convirtiéndola en variables dummy: k − 1 indicadoras para k categorías, dejando una como categoría de referencia. Todos los coeficientes se interpretan frente a esa referencia, así que hay que decir explícitamente cuál es.
¿Puedo decir que un predictor «causa» el resultado?
No en un diseño transversal. La regresión controla las variables que incluiste, no las que no mediste. La redacción correcta es «se asocia con» o «predice», y la discusión debe reconocer las variables omitidas.
Escribe el capítulo con la interpretación al lado
Correr el modelo toma diez minutos; convertir la salida en un capítulo que se defienda toma varios días. Con Tesify puedes redactar el capítulo de resultados con tu tabla de coeficientes a la vista, mantener la coherencia con la metodología que ya escribiste y dejar las referencias formateadas en APA 7 o Icontec según lo que exija tu programa. La herramienta acompaña la escritura y organiza las fuentes; el criterio metodológico —qué predictores entran y cómo se interpretan— sigue siendo tuyo, que es exactamente lo que el jurado va a evaluar.