Un trabajo de grado de Ciencia de Datos o Inteligencia Artificial necesita un dataset lo suficientemente grande, limpio y bien documentado para entrenar o evaluar un modelo — y encontrarlo suele tomar más tiempo del que un estudiante planea. Esta guía reúne cuatro fuentes de datasets abiertos que cubren la mayoría de los casos: dos colombianas (datos.gov.co y el catálogo de microdatos del DANE) y dos internacionales de referencia en la disciplina (Kaggle y el UCI Machine Learning Repository), con cuándo usar cada una y cómo documentarlo ante el jurado.
Panorama: cuatro fuentes con funciones distintas
| Fuente | Qué ofrece | Mejor para |
|---|---|---|
| datos.gov.co | Catálogo transversal de datos abiertos del Estado colombiano, mayormente registros administrativos agregados | Problemas aplicados al contexto colombiano con datos públicos oficiales |
| DANE (Catálogo Central de Datos) | Microdatos de encuestas y operaciones estadísticas oficiales, con diseño muestral documentado | Modelos que requieren variables sociodemográficas individuales representativas de Colombia |
| Kaggle | Miles de datasets subidos por la comunidad, muchos ya limpios y con notebooks de referencia | Práctica, benchmarking y datasets de dominio general o internacional |
| UCI Machine Learning Repository | Datasets curados académicamente, usados como referencia histórica en la literatura de machine learning | Comparar tu modelo contra resultados publicados en papers que usan el mismo dataset |
datos.gov.co: el catálogo transversal del Estado colombiano
El portal de datos abiertos del Estado colombiano reúne miles de conjuntos publicados por entidades nacionales y territoriales, descargables sin registro. Para un trabajo de grado de Ciencia de Datos e IA, es la fuente correcta cuando tu problema tiene un componente aplicado al contexto colombiano —por ejemplo, un modelo de predicción sobre movilidad, seguridad o salud pública usando registros administrativos— y no necesitas microdatos individuales de encuesta, sino series agregadas por entidad, municipio o periodo.
DANE: microdatos con diseño muestral documentado
El Catálogo Central de Datos del DANE publica microdatos de encuestas y operaciones estadísticas con su ficha metodológica, su cuestionario y su diccionario de variables. Es la fuente pertinente cuando tu modelo necesita variables a nivel de persona u hogar con representatividad estadística de Colombia —por ejemplo, un modelo de clasificación entrenado con variables sociodemográficas de una encuesta de hogares— en vez de un dataset genérico sin diseño muestral conocido.
Kaggle: la plataforma de referencia para práctica y benchmarking
Kaggle es una plataforma internacional que reúne miles de datasets subidos por su comunidad, muchos de ellos ya limpios, documentados y acompañados de notebooks de ejemplo que otros usuarios publicaron con su propio análisis. Es la fuente correcta cuando tu trabajo necesita practicar una técnica sobre un dominio ya trabajado por la comunidad —visión por computador, procesamiento de lenguaje natural, series de tiempo genéricas— o cuando quieres comparar tu enfoque contra soluciones publicadas por otros participantes sobre el mismo conjunto. La calidad de la documentación varía mucho de un dataset a otro, así que conviene revisar la licencia y la fuente original antes de asumir que el dataset es confiable sin más verificación.
UCI Machine Learning Repository: la referencia académica histórica
El UCI Machine Learning Repository, mantenido por la Universidad de California en Irvine, es uno de los repositorios de datasets más citados en la literatura académica de machine learning desde hace décadas. Su valor específico para un trabajo de grado es que muchos de sus datasets aparecen citados en papers publicados, lo que te permite comparar el desempeño de tu modelo contra resultados ya reportados en la literatura con el mismo conjunto de datos — algo que un dataset nuevo de Kaggle rara vez permite, porque no tiene ese historial de comparación académica.
Qué fuente corresponde a cada tipo de pregunta
- «¿Mi modelo necesita datos administrativos agregados de una entidad colombiana?» → datos.gov.co.
- «¿Mi modelo necesita microdatos individuales representativos de la población colombiana?» → DANE.
- «¿Necesito practicar una técnica con un dataset ya limpio y bien documentado por la comunidad?» → Kaggle.
- «¿Necesito comparar mi modelo contra resultados ya publicados en la literatura académica?» → UCI Machine Learning Repository.
Muchos trabajos de grado combinan dos fuentes: por ejemplo, un dataset del UCI Repository para validar la implementación del modelo contra resultados conocidos, y luego un dataset propio construido a partir de datos.gov.co o del DANE para la aplicación específica al contexto colombiano que justifica el trabajo. Antes de comprometerte con una fuente, conviene revisar el flujo completo de decisiones: la guía sobre el uso de microdatos del DANE en el trabajo de grado explica qué mirar en la ficha de una operación estadística antes de descargarla, una lógica que aplica igual de bien a cualquier catálogo de datasets.
La protección de datos personales no desaparece por usar un dataset ya existente
Usar un dataset ya construido —sea de datos.gov.co, del DANE, de Kaggle o del UCI Repository— no te exime de las obligaciones de protección de datos si el conjunto contiene información personal identificable o combinaciones de variables que permiten reidentificar a una persona. Es un punto que suele generar preguntas en la sustentación de trabajos de Ciencia de Datos e IA, y merece su propio tratamiento: la guía sobre protección de datos en datasets de entrenamiento explica cómo se gestiona el riesgo de reidentificación y qué técnicas de anonimización documentar en el capítulo metodológico.
Y si tu plan es complementar cualquiera de estos datasets con un catálogo transversal más general, sin el enfoque especializado en microdatos del DANE, la guía sobre datos.gov.co en el trabajo de grado detalla los límites del catálogo general —el tope del contador, la diferencia entre registros agregados y microdatos— que conviene conocer antes de comprometer tu diseño con la existencia de «los datos que seguro habrá».
Cómo se ve aplicado: ejemplo de justificación de fuente
Ejemplo (extracto, tema: modelo de predicción de deserción universitaria en una institución colombiana): «Se descartó el uso de un dataset genérico de Kaggle sobre deserción escolar, por corresponder a un contexto educativo y un nivel de formación distintos al de la población objetivo de este estudio. En su lugar, se construyó el conjunto de entrenamiento a partir de microdatos administrativos de la institución, complementados con variables socioeconómicas agregadas del Catálogo Central de Datos del DANE para el municipio de residencia de cada estudiante. La arquitectura del modelo se validó previamente contra el dataset «Student Performance» del UCI Machine Learning Repository, ampliamente citado en la literatura de predicción de rendimiento académico, para verificar que la implementación reproducía resultados comparables antes de aplicarla al caso colombiano.»
Nota del comité: el fragmento hace tres cosas que un jurado espera ver: explica por qué se descartó una fuente aparentemente cómoda pero poco pertinente, declara el origen exacto de cada variable usada y separa claramente el dataset de validación técnica del dataset de aplicación al problema real. Esa separación —validar primero, aplicar después— es exactamente lo que distingue un trabajo bien construido de uno que solo reporta una métrica de exactitud sin contexto.
Cómo documentar la elección del dataset en el capítulo de método
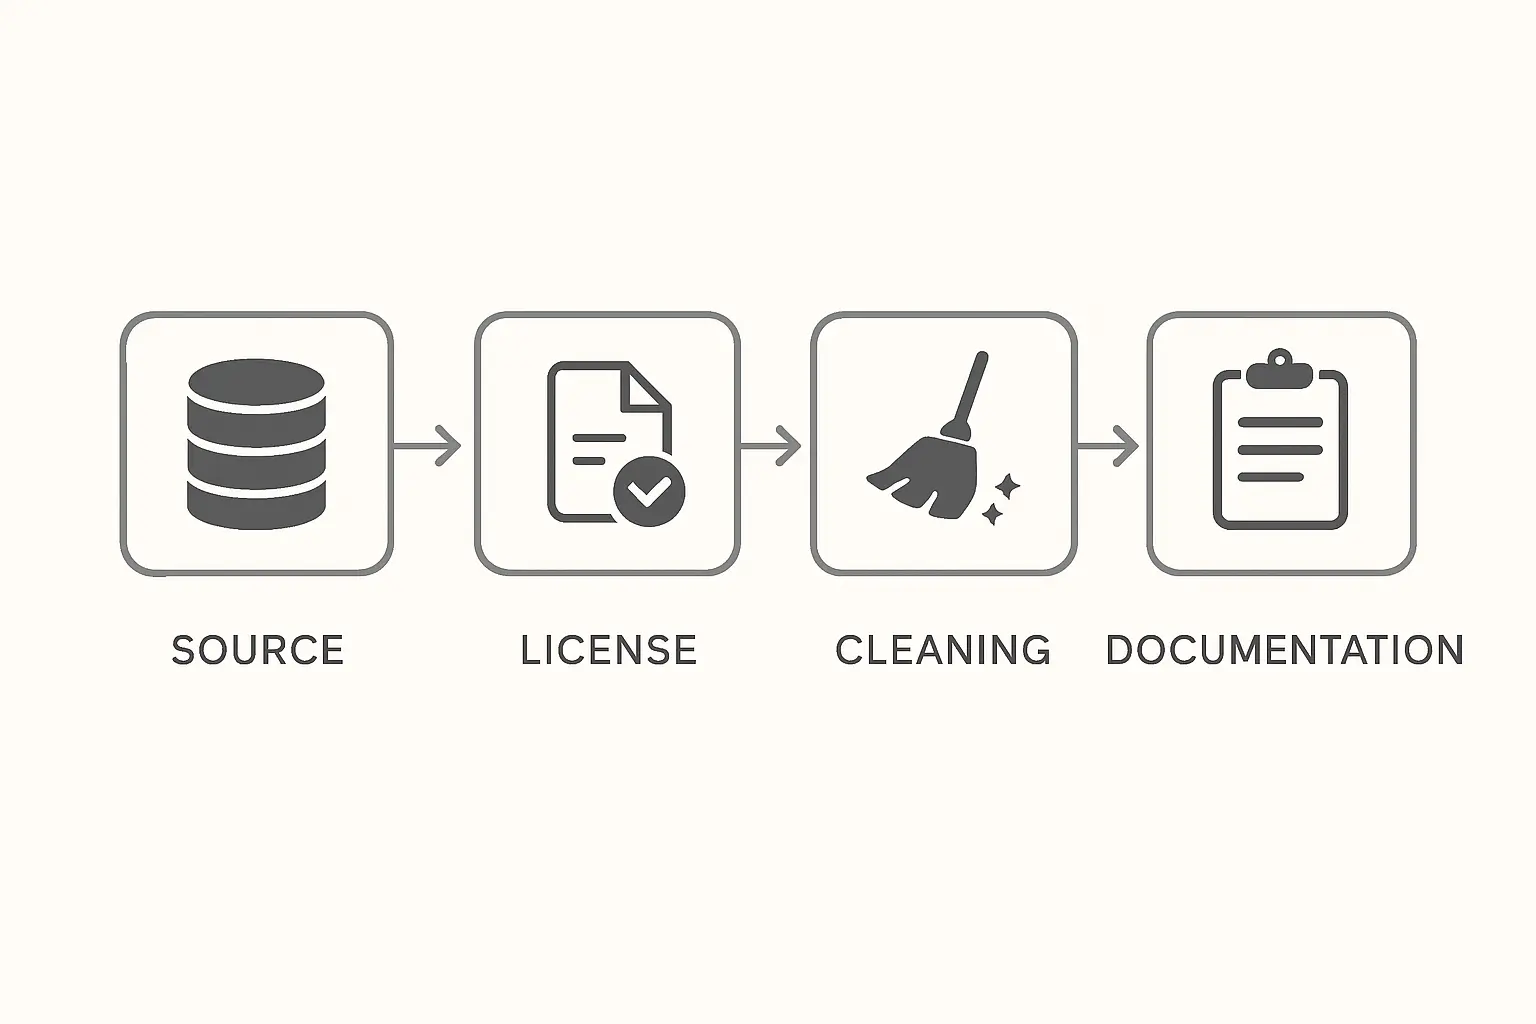
Un jurado que revisa un trabajo de Ciencia de Datos o IA espera encontrar, además de la descripción del modelo, una justificación explícita de por qué elegiste ese dataset y no otro. La justificación tiene tres piezas: pertinencia (el dataset cubre las variables y el fenómeno que tu pregunta de investigación exige), procedencia (fuente exacta, fecha de descarga, versión) y límites declarados (qué preguntas el dataset no puede responder y cómo lo compensas en el diseño o en las conclusiones). Un dataset elegido solo porque «estaba disponible y limpio» sin esa justificación suele motivar observaciones del jurado en esta modalidad.
Errores frecuentes al elegir un dataset
- No citar la versión exacta del dataset. Muchos datasets en Kaggle y datos.gov.co se actualizan con el tiempo; sin la fecha de descarga o el número de versión, tu análisis no es reproducible.
- Confundir un dataset de Kaggle sin curaduría académica con una fuente de referencia comparable al UCI Repository. Ambos son útiles, pero cumplen funciones distintas en la justificación metodológica.
- Asumir que un dataset «público» no tiene restricciones de licencia. Muchos datasets de Kaggle tienen licencias de solo-investigación o restricciones de redistribución que conviene verificar antes de publicar el modelo entrenado.
- No verificar si el dataset contiene datos personales o sensibles antes de entrenar el modelo. La ausencia de nombres no garantiza que el conjunto sea anónimo si otras variables permiten reidentificación.
- Elegir el dataset antes de definir bien la pregunta de investigación. El orden correcto es definir qué necesitas medir y después buscar el dataset que lo permite, no al revés.
Cómo citar un dataset correctamente
Un dataset se cita con la misma exigencia que cualquier fuente de datos secundarios: autor o entidad que lo publicó, título exacto, año o fecha de publicación, versión si aplica, y la URL o el identificador persistente (DOI) cuando el repositorio lo asigna, más la fecha en que lo descargaste. Por ejemplo: «DANE. (2026). Gran Encuesta Integrada de Hogares. Catálogo Central de Datos.» Evita citar solo el nombre de la plataforma («dataset de Kaggle») sin el nombre exacto del conjunto y su autor original — es la misma exigencia de precisión que se aplica a cualquier fuente de datos oficiales en un trabajo de grado colombiano.
Preguntas frecuentes
¿Puedo basar todo mi trabajo de grado en un dataset descargado, sin recolectar datos propios?
En muchos programas de Ciencia de Datos e IA es una modalidad aceptada, siempre que la pregunta de investigación se pueda responder con las variables disponibles en el dataset y que documentes con rigor su procedencia y sus límites; confírmalo en el reglamento de tu programa.
¿Necesito el aval del comité de ética si uso un dataset público ya existente?
Depende de si el dataset contiene datos personales identificables o sensibles. Muchos comités consideran de menor riesgo el uso de datos secundarios ya anonimizados, pero verifica con tu director si tu diseño específico requiere el trámite según la Resolución 8430.
¿Qué diferencia hay entre datos.gov.co y el catálogo de microdatos del DANE?
datos.gov.co es un catálogo transversal con registros mayormente agregados de todas las entidades del Estado; el catálogo del DANE es especializado en microdatos de encuestas con diseño muestral documentado. Si tu modelo necesita variables individuales representativas, empieza por el DANE.
¿Los datasets de Kaggle sirven para un trabajo de grado serio, o solo para práctica?
Sirven para un trabajo de grado serio si el dataset está bien documentado, tiene una licencia clara y es pertinente para tu pregunta de investigación; el hecho de venir de una plataforma comunitaria no lo descalifica, pero exige una verificación de calidad que un catálogo institucional ya hace por ti.
¿Por qué usaría un dataset del UCI Repository en vez de uno más reciente de Kaggle?
Porque su valor específico es la comparabilidad: al usar un dataset citado en la literatura académica, puedes contrastar el desempeño de tu modelo contra resultados ya publicados, algo que fortalece la discusión de resultados de un trabajo de grado.
¿Puedo combinar datasets de distintas fuentes en el mismo modelo?
Sí, siempre que documentes cómo se cruzan o se unen, que compartan una unidad de análisis compatible y que declares cualquier diferencia de periodo, cobertura o metodología entre las fuentes combinadas.
¿Ya elegiste tu dataset y necesitas documentar la decisión ante el jurado? Estructura tu trabajo de grado de Ciencia de Datos en Tesify y deja la justificación metodológica, las fuentes y las citas organizadas desde el primer borrador.